Grundhaltung
Ein Migrationswerkzeug, das historisch gewachsene Daten in ein restriktives Zielsystem überführt, tut gut daran, sich auf eine klar abgegrenzte Aufgabe zu beschränken: Daten technisch überführen. Möglichst vollständig, deterministisch und nachvollziehbar.
Über Inhalte trifft es grundsätzlich keine fachliche Aussage – nicht weil es dazu prinzipiell unfähig wäre, sondern weil Inhaltsbewertung nicht Bestandteil der eigentlichen Migration ist. Wer Werte beurteilt, benötigt Domänenwissen, das außerhalb der technischen Überführung liegt. Wer Strukturen überführt, benötigt dieses Wissen für viele technische Schritte nicht.
Die Konsequenz dieser Haltung ist ein Werkzeug, das bewusst zurückhaltend arbeitet: Es macht Strukturen sichtbar, führt Daten nach definierten Regeln über und dokumentiert die einzelnen Schritte. Es sollte möglichst keine Aussage treffen, die sich aus den vorhandenen technischen Informationen nicht hinreichend begründen lässt.
An dieser Stelle sei erwähnt, es ist eine von vielen Ansätzen und dient hier lediglich als Betrachungsmöglichkeit. Zu einem solchen Hinweis kommen manchmal kritische Worte der Beliebigkeit eines Ansatzes. Für mich jedoch ist klar, dass es selbstverständlich nicht die eine richtige Betrachtung gibt, sondern immer den richtigen Ansatz für ein definiertes Ziel zu formulieren.
Struktur vor Semantik
Der erste und wichtigste Grundsatz lautet: Struktur wird erkannt, Bedeutung wird nicht geraten.
Viele Migrationswerkzeuge arbeiten zumindest teilweise mit Ähnlichkeiten: ähnlichen Feldnamen, ähnlichen Werten oder vergleichbaren Mustern. Das kann hilfreich sein, birgt aber das Risiko stiller Zusammenführungen, die im Zielsystem später als fachlich falsche Verschmelzungen sichtbar werden.
Ein restriktiverer Ansatz geht deshalb den umgekehrten Weg. Statt zunächst Gemeinsamkeiten zu vermuten, werden Unterschiede sichtbar gemacht.
Datensätze mit derselben kanonisch bestimmten Struktur können gemeinsam verarbeitet werden. Datensätze mit strukturellen Abweichungen werden zunächst getrennt behandelt. Wo keine explizite Regel besteht, findet keine automatische Interpretation statt.
In der Praxis bedeutet das: Eine Struktur gilt dann als identisch mit einer anderen, wenn ihre für die Migration relevanten Merkmale nach einer definierten Normalisierung übereinstimmen.
Je nach Quellsystem können dazu beispielsweise gehören:
- Feldnamen
- Groß- und Kleinschreibung
- Datentypen
- Feldlängen
- Verschachtelungen
- technische Herkunft
- definierte Reihenfolgen, sofern diese im jeweiligen Datenmodell strukturell relevant sind
Nicht jede technische Darstellungsreihenfolge muss dabei automatisch Teil der Struktur sein. Liefert ein Quellsystem dieselben Felder lediglich in unterschiedlicher Serialisierungsreihenfolge, kann vor der Strukturbildung eine kanonische Sortierung sinnvoll sein.
Entscheidend ist, dass die Regeln vorab definiert werden und nicht während der Migration situativ verändert werden.
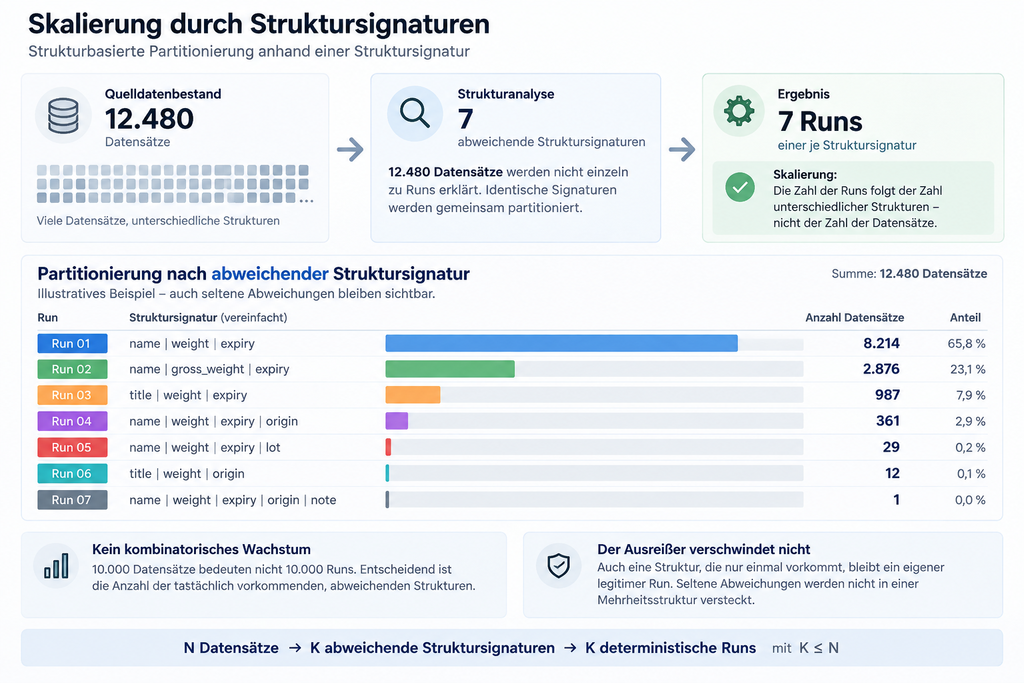
Auch ein Datensatz, der eine bestimmte Struktur nur einmal repräsentiert, kann einen legitimen eigenen Lauf bilden. Eine Mindestgröße für Strukturgruppen ist technisch nicht erforderlich.
Vollständigkeit durch Partition
Bevor Inhalte geschrieben werden, sollte die relevante Menge der Quelldaten möglichst vollständig partitioniert werden.
Ein Durchlauf über den definierten Bestand ermittelt für jeden betrachteten Datensatz seine technische Struktur. Danach lässt sich feststellen, welche unterschiedlichen Strukturgruppen vorhanden sind und welche Datensätze jeweils zu ihnen gehören.
Diese Partition bildet die Grundlage der weiteren Verarbeitung.
Sie ist innerhalb des definierten Suchraums vollständig, wenn jeder dort erfasste Datensatz genau einer Strukturgruppe zugeordnet werden kann. Sie ist deterministisch, wenn dieselben Eingangsdaten unter denselben Regeln dieselbe Partition erzeugen. Sie ist nachvollziehbar, wenn die verwendeten Regeln und Strukturkennungen reproduzierbar dokumentiert werden.
Die Reihenfolge, in der einzelne Strukturen abgearbeitet werden, sollte ebenfalls deterministisch festgelegt werden.
Dafür kann beispielsweise eine Sortierung nach einer stabilen Strukturkennung oder einem reproduzierbar gebildeten Hash verwendet werden.
Damit lässt sich erreichen, dass unterschiedliche Personen oder Systeme bei demselben Datenbestand und denselben Regeln dieselbe Bearbeitungsreihenfolge erhalten.
Eine menschliche Auswahl von Referenzdatensätzen kann als Einstiegspunkt sinnvoll sein, insbesondere bei überschaubaren oder explorativen Migrationen.
Sie ersetzt jedoch keine vollständige Partition des betrachteten Gesamtbestands. Wer innerhalb eines definierten Datenraums eine belastbare Vollständigkeitskontrolle erreichen möchte, benötigt letztlich einen vollständigen Durchlauf über diesen Bestand.
Der leere Schreibzugriff
Zwischen dem Moment, in dem eine Struktur erkannt wurde, und dem Moment, in dem fachliche Inhalte geschrieben werden, kann ein bewusster Zwischenschritt liegen: das Anlegen eines leeren Zielcontainers.
Dieser Schritt überträgt noch keine fachlichen Werte.
Er erzeugt im Zielsystem einen vorbereiteten Anker, an dem später Inhalte befestigt werden können. Bereits vorhandene Zielstrukturen sollten dabei nach einer klar definierten Regel behandelt werden. Insbesondere sollten bestehende Inhalte nicht allein deshalb verändert werden, weil eine Migration vorbereitet wird.
Fehlende Strukturen können angelegt werden, sofern das Zielsystem und der gewählte Migrationsmodus dies erlauben.
Der Vorteil dieses Schritts liegt in seiner inhaltlichen Risikominimierung.
Da noch keine fachlichen Werte übertragen werden, ist das Risiko einer falschen inhaltlichen Zuordnung in dieser Phase deutlich geringer.
Dennoch bleibt auch das Anlegen eines leeren Containers ein echter Schreibzugriff. Je nach Zielsystem können dadurch Validierungen, Hooks, Events, Nebenwirkungen oder technische Limits ausgelöst werden.
Deshalb sollte auch dieser Schritt protokolliert und verifiziert werden.
So entsteht ein prüfbarer Zwischenzustand:
- sitzt der Zielanker an der erwarteten Stelle?
- wurde die richtige Struktur erzeugt?
- stimmt die Anzahl vorbereiteter Objekte?
- wurden bestehende Zielstrukturen wie vorgesehen behandelt?
Erst wenn dieser Zustand erfolgreich geprüft wurde, sollte der nächste Schritt freigegeben werden.
Damit wird der Übergang von „Struktur erkannt“ zu „Inhalte geschrieben“ nicht als einzelner Sprung behandelt, sondern als Abfolge nachvollziehbarer Zustände.
Mapping als bewusste Entscheidung
Die Zuordnung von Quellfeldern zu Zielfeldern ist typischerweise der Schritt, an dem fachliches Wissen erforderlich wird.
Genau deshalb kann es sinnvoll sein, diese Entscheidung bewusst manuell zu belassen.
Das Werkzeug zeigt die verfügbaren Quellfelder, ihre technische Herkunft und gegebenenfalls Beispielwerte als Verständnishilfe.
Es muss daraus jedoch keine automatische Empfehlung ableiten.
Die Entscheidung, welches Quellfeld zu welchem Zielfeld gehört, kann beim zuständigen Administrator oder einer fachlich verantwortlichen Person verbleiben.
Diese Zurückhaltung ist kein Funktionsdefizit.
Gleiche oder ähnliche Begriffe garantieren keine gleiche Bedeutung.
Ein Feld mit einem Datumsnamen kann beispielsweise enthalten:
- ein Herstellungsdatum
- ein Haltbarkeitsdatum
- ein Importdatum
- ein Änderungsdatum
- ein kundenspezifisch definiertes Datum
Ein Feld mit einem Gewichtsnamen kann Netto-, Brutto-, Versand-, Portions- oder Verpackungsgewicht meinen.
Eine automatische Zuordnung kann daher technisch plausibel erscheinen und dennoch fachlich falsch sein.
Jede Zuordnung sollte optional sein.
Es muss nicht zwingend jedes Quellfeld übertragen werden. Ebenso muss nicht jedes Zielfeld befüllt werden.
Als minimale Voraussetzung für einen schreibenden Mapping-Lauf genügt, dass mindestens eine explizite Zuordnung vorhanden ist.
Leere Quellwerte sollten grundsätzlich nicht ungefragt vorhandene Zielwerte überschreiben.
Ob ein leerer Wert vollständig übersprungen, als explizite Löschanweisung behandelt oder gesondert markiert wird, sollte durch eine vorher festgelegte Regel bestimmt werden.
Mehrere Quellen für ein Ziel
Eine flexible Migrationsengine sollte auch den Fall unterstützen können, dass mehrere mögliche Quellfelder verschiedener Datensätze demselben Zielfeld zugeordnet werden.
Damit entsteht jedoch eine zusätzliche Anforderung: Die Verarbeitung muss auch in diesem Fall deterministisch bleiben.
Wenn beispielsweise zwei Quellfelder gleichzeitig Werte enthalten, darf die Engine nicht spontan entscheiden, welcher Wert verwendet wird.
Stattdessen sollte eine explizite Regel festgelegt werden.
Denkbar sind beispielsweise:
- feste Prioritätsreihenfolge
- erster nichtleerer Wert
- letzter nichtleerer Wert
- definierte Zusammenführung
- Abbruch bei Mehrdeutigkeit
- technische Quarantäne bei konkurrierenden Werten
Welche Regel fachlich sinnvoll ist, hängt vom jeweiligen Anwendungsfall ab.
Entscheidend ist weniger die konkrete Strategie als die Tatsache, dass sie vorher definiert und reproduzierbar ist.
Eine implizite Auswahl durch die Engine sollte vermieden werden.
Zusätzliche Quellfelder, für die das vorgesehene Zielschema kein passendes Feld besitzt, können gegebenenfalls als definierte Erweiterungen übernommen werden.
Auch dafür sollte jedoch klar sein, in welchem Namensraum, Format und Lebenszyklus solche Erweiterungen geführt werden.
Idempotenz als Grundprinzip
Migrationen laufen in der Praxis selten in einer vollständig störungsfreien Einzelsitzung.
Browser werden neu geladen, Anfragen erneut ausgelöst, Pakete später wieder geöffnet und Arbeitsvorgänge über mehrere Tage oder Wochen verteilt.
Je nach Organisation greifen auch mehrere Personen nacheinander auf denselben Migrationskontext zu.
Ein Migrationswerkzeug, das wiederholte Operationen nicht kontrolliert behandeln kann, riskiert in dieser Realität doppelte oder widersprüchliche Zustände.
Ein idempotenter Ansatz versucht deshalb, eine bereits ausgeführte identische Operation zu erkennen und den bestehenden Zustand zurückzuliefern, anstatt denselben Schreibvorgang erneut auszuführen.
Eine Wiederholung ist damit kein außergewöhnlicher Fehlerfall, sondern ein erwartbarer Betriebszustand.
Idempotenz kann unter anderem durch stabile Vorberechnung des Operationskontexts erreicht werden.
Jede schreibende Operation wird an Merkmale gebunden, die den relevanten Kontext ausreichend eindeutig beschreiben.
Dazu können beispielsweise gehören:
- Zieltyp
- Strukturkennung
- betroffene Datensätze
- Mapping-Version
- ausgewählte Felder
- Transformationsregeln
- Zielkontext
- gegebenenfalls Schema-Version
Aus diesen Merkmalen kann eine stabile Operationskennung oder ein Hash gebildet werden.
Wird derselbe Schritt mit demselben Kontext erneut angefragt, kann das Werkzeug erkennen, dass bereits ein passendes Ergebnis existiert.
Weicht die Auswahl oder Konfiguration ab, sollte nicht stillschweigend dieselbe Operation weiterverwendet werden.
Stattdessen kann die vorherige Operation als überholt oder superseded markiert und eine neue Operation mit eigener Kennung erzeugt werden.
Dadurch bleibt nachvollziehbar, welche Entscheidung zu welchem Ergebnis geführt hat.
Idempotenz erleichtert es erheblich, einen Migrationsvorgang über Zeit, über Rechner und über unterschiedliche Rollen hinweg fortzuführen, ohne dafür zwangsläufig ein vollständig ausgebautes kollaboratives Multi-User-System zu benötigen.
Zwei Zustände genügen auf Workflow-Ebene
Ein Migrationslauf kann auf seiner dauerhaften Workflow-Ebene mit sehr wenigen Zuständen auskommen.
Im Kern können beispielsweise zwei dauerhafte Zustände genügen:
vorbereitet und überführt.
Andere Schritte wie Auswahl, Mapping, Prüfung oder Vorschau können als Arbeits- oder Durchlaufzustände behandelt werden.
Sie müssen nicht zwangsläufig als eigenständige dauerhafte fachliche Realität bestehen bleiben.
Dadurch lässt sich vermeiden, dass eine schwer interpretierbare Zwischenwelt aus „fast migrierten“, „teilweise bestätigten“ oder „irgendwie begonnenen“ Objekten entsteht.
Ein vorbereiteter Lauf enthält die notwendigen Informationen, um reproduzierbar fortgeführt zu werden.
Ein überführter Lauf dokumentiert, dass die vorgesehene Schreiboperation abgeschlossen wurde.
Diese beiden Workflow-Zustände dürfen jedoch nicht mit dem Ergebnisstatus einzelner Datensätze verwechselt werden.
Innerhalb eines abgeschlossenen Laufs können einzelne Quelldatensätze beispielsweise als
- erfolgreich überführt
- bewusst übersprungen
- technisch nicht überführbar
- in technische Quarantäne verschoben
klassifiziert sein.
Die Workflow-Ebene beschreibt also den Zustand des Migrationslaufs.
Die Ergebnis-Ebene beschreibt, was mit den einzelnen Datensätzen innerhalb dieses Laufs geschehen ist.
Diese Trennung reduziert Mehrdeutigkeiten und erleichtert die spätere Auswertung.
Persistente Arbeitskontexte
Ein migrationsrelevanter Vorgang ist mehr als eine UI-Sitzung.
Er kann unter anderem umfassen:
- einen Zieltyp
- einen definierten Suchradius oder eine Auswahlgrenze
- eine oder mehrere Referenzen
- eine bestätigte Auswahl relevanter Felder
- eine Menge betroffener Datensätze
- eine oder mehrere Strukturgruppen
- ein oder mehrere ausführbare Läufe
- eine Mapping-Konfiguration
- einen gespeicherten Ausgangszustand
- ausgeführte Operationen
- einen dokumentierten Endzustand
Diese Bestandteile sollten persistent gespeichert werden, wenn der Vorgang über längere Zeit reproduzierbar und delegierbar bleiben soll.
Werden sie ausschließlich flüchtig im Browser gehalten, existiert der Migrationsvorgang technisch nur so lange zuverlässig, wie diese Sitzung besteht.
Durch Persistenz wird der Vorgang zu einem Arbeitsobjekt.
Person A kann beispielsweise die Erkundung des Quellbestands durchführen.
Person B kann später das Mapping festlegen.
Person C kann zu einem anderen Zeitpunkt den Commit auslösen.
Dabei können unterschiedliche Rechner, Sitzungen und Rollen beteiligt sein.
Die Persistenz ersetzt keinen Freigabe- oder Berechtigungsmechanismus.
Sie ist lediglich die technische Voraussetzung dafür, dass ein Migrationsvorgang unabhängig von einer einzelnen Sitzung bestehen bleibt.
Sicherheitsnetze
Schreibende Migrationsschritte sollten nach Möglichkeit durch einen Snapshot oder eine vergleichbare Zustandsaufnahme abgesichert werden.
Vor dem ersten relevanten Schreibzugriff wird der aktuelle Zustand der betroffenen Zieldaten festgehalten.
Schlägt eine Operation fehl oder muss sie rückgängig gemacht werden, steht dadurch eine Referenz auf den vorherigen Zustand zur Verfügung.
Ein Rollback sollte jedoch nicht blind erfolgen.
Vor einer Wiederherstellung kann geprüft werden, ob der aktuelle Zustand noch dem erwarteten Nachher-Zustand entspricht, den der Migrationslauf selbst erzeugt hat.
Wurde das Zielobjekt zwischenzeitlich manuell oder durch einen anderen Prozess verändert, sollte die Wiederherstellung nicht automatisch über diesen neuen Zustand hinwegschreiben.
Stattdessen kann das Objekt als Konflikt behandelt werden.
So lässt sich verhindern, dass eine technische Wiederherstellung spätere legitime Änderungen unbeabsichtigt vernichtet.
Der Grundsatz lautet daher nicht absolut „manuelle Änderungen sind unantastbar“, sondern präziser:
Ein Rollback sollte keine zwischenzeitlich entstandenen Änderungen überschreiben, deren Herkunft und Bedeutung der Migrationsprozess nicht sicher beurteilen kann.
Auch die Wiederaufnahme oder Korrektur eines bereits abgeschlossenen Laufs sollte dieser Logik folgen.
Ein bereits überführter Lauf sollte nicht stillschweigend mit einer neuen Zuordnung überschrieben werden.
Wenn eine andere Mapping-Entscheidung erforderlich wird, kann der bisherige Lauf bewusst als überholt markiert und durch einen neuen Lauf ersetzt werden.
Dadurch bleibt die Historie erhalten.
Migration ist keine Datenbereinigung
Migration und Datenbereinigung sind eng verwandt, aber nicht identisch.
Eine technische Migration kann Normalisierungen durchführen, soweit sie für die Darstellung im Zielsystem erforderlich, vorher definiert und deterministisch sind.
Dazu können beispielsweise gehören:
- Zeichensatzkonvertierungen
- technische Typumwandlungen
- kanonische Formatierung
- eindeutig definierte Einheitenkonvertierungen
- Anpassung an technische Längen- oder Schemaanforderungen
Davon zu unterscheiden ist eine fachliche Korrektur.
Ein Wert sollte nicht allein deshalb verändert werden, weil er ungewöhnlich, unvollständig oder unplausibel erscheint.
Ein als „MHD“ bezeichnetes Feld wird nicht automatisch korrigiert, weil sein Inhalt wie ein anderes Datum aussieht.
Ein Gewicht wird nicht eigenständig neu interpretiert, weil ein Wert ungewöhnlich hoch erscheint.
Ein Produktname wird nicht semantisch verbessert, nur weil er inkonsistent geschrieben ist.
Soll eine fachliche Bereinigung stattfinden, sollte sie als eigener, dokumentierter Prozess vor oder nach der technischen Migration behandelt werden.
Dadurch bleibt nachvollziehbar:
- welche Veränderung aus der technischen Überführung stammt
- welche Veränderung aus einer fachlichen Entscheidung stammt
- wer diese Entscheidung getroffen hat
- nach welcher Regel sie erfolgt ist
Diese Trennung schützt sowohl die Auditierbarkeit als auch die fachliche Verantwortungszuordnung.
Technische Quarantäne
Nicht jeder Quelldatensatz muss unter allen Umständen automatisch in das Zielsystem überführt werden können.
Es kann Datensätze geben, für die technische Voraussetzungen fehlen, deren Struktur unbekannt ist oder bei denen konkurrierende Regeln keine eindeutige Verarbeitung zulassen.
Für solche Fälle ist eine technische Quarantäne sinnvoll.
Der Begriff ist bewusst neutral.
Ein Datensatz in technischer Quarantäne wird nicht als fachlich falsch, ungültig oder wertlos bewertet.
Er bedeutet lediglich:
Unter den aktuell definierten technischen Regeln konnte dieser Datensatz nicht eindeutig und kontrolliert überführt werden.
Mögliche Gründe können sein:
- unbekannte Struktur
- fehlende Zielstruktur
- technische API-Beschränkung
- konkurrierende Quellwerte
- nicht unterstützter Datentyp
- beschädigte Serialisierung
- fehlende Berechtigung
- Versionskonflikt
- nicht erfüllte Vorbedingung
Dadurch bleibt die Migration ehrlich.
Sie muss nicht so tun, als könne jeder Sonderfall automatisch gelöst werden.
Gleichzeitig geht kein Datensatz still verloren.
Verantwortungsgrenze
Die technische Migration endet mit der definierten Übergabe des Zielbestands und der dazugehörigen Dokumentation.
Alles, was danach folgt – fachliche Prüfung, Plausibilitätsbewertung, Konsistenzkontrolle, regulatorische Bewertung oder domänenspezifische Geschäftsregeln – liegt grundsätzlich im Verantwortungsbereich des Betreibers beziehungsweise der dafür zuständigen Fachrolle.
Diese Grenze ist keine bloße Absicherung.
Sie beschreibt, welche Aufgabe das Werkzeug übernimmt.
Es überführt Daten technisch nach definierten Regeln und dokumentiert diesen Vorgang.
Es trifft ohne zusätzliche fachliche Logik keine Aussage über:
- die tatsächliche Bedeutung eines Werts
- seine fachliche Richtigkeit
- seine Aktualität
- seine regulatorische Zulässigkeit
- seine geschäftliche Plausibilität
Je klarer diese Grenze gezogen wird, desto leichter lassen sich technische Deterministik und fachliche Verantwortung voneinander trennen.
Automatisierung findet dort statt, wo eine technische Entscheidung reproduzierbar getroffen werden kann.
Wo Semantik beginnt, sollte entweder eine explizite fachliche Regel oder eine bewusste menschliche Entscheidung erforderlich sein.
Was am Ende steht
Am Ende einer kontrollierten Migration sollte idealerweise Folgendes vorliegen:
- ein Zielbestand, der entsprechend den definierten technischen Regeln in das vorgesehene Zielschema überführt wurde
- ein Bericht, der für jeden innerhalb des definierten Migrationsraums betrachteten Quelldatensatz einen dokumentierten Ergebnisstatus enthält
- eine Liste der technisch nicht überführten oder in Quarantäne befindlichen Datensätze mit Begründung
- eine Dokumentation der verwendeten Zuordnungen und ihrer Versionsstände
- eine Historie der ausgeführten Operationen
- ein Audit-Trail über relevante Freigaben, Commits, Wiederholungen, Konflikte und Fehler
- soweit vorgesehen, die für Rollback oder Nachweis erforderlichen Ausgangs- und Nachher-Zustände
Damit ist die technische Migration abgeschlossen.
Was anschließend fachlich mit den Daten geschieht, liegt außerhalb dieser Aufgabe.
Das Werkzeug hat seinen vorgesehenen Beitrag geleistet:
Es hat Daten nach definierten Regeln überführt, ohne mehr über ihre Bedeutung zu behaupten, als sich technisch begründen lässt.
Abweichung vor Gemeinsamkeit
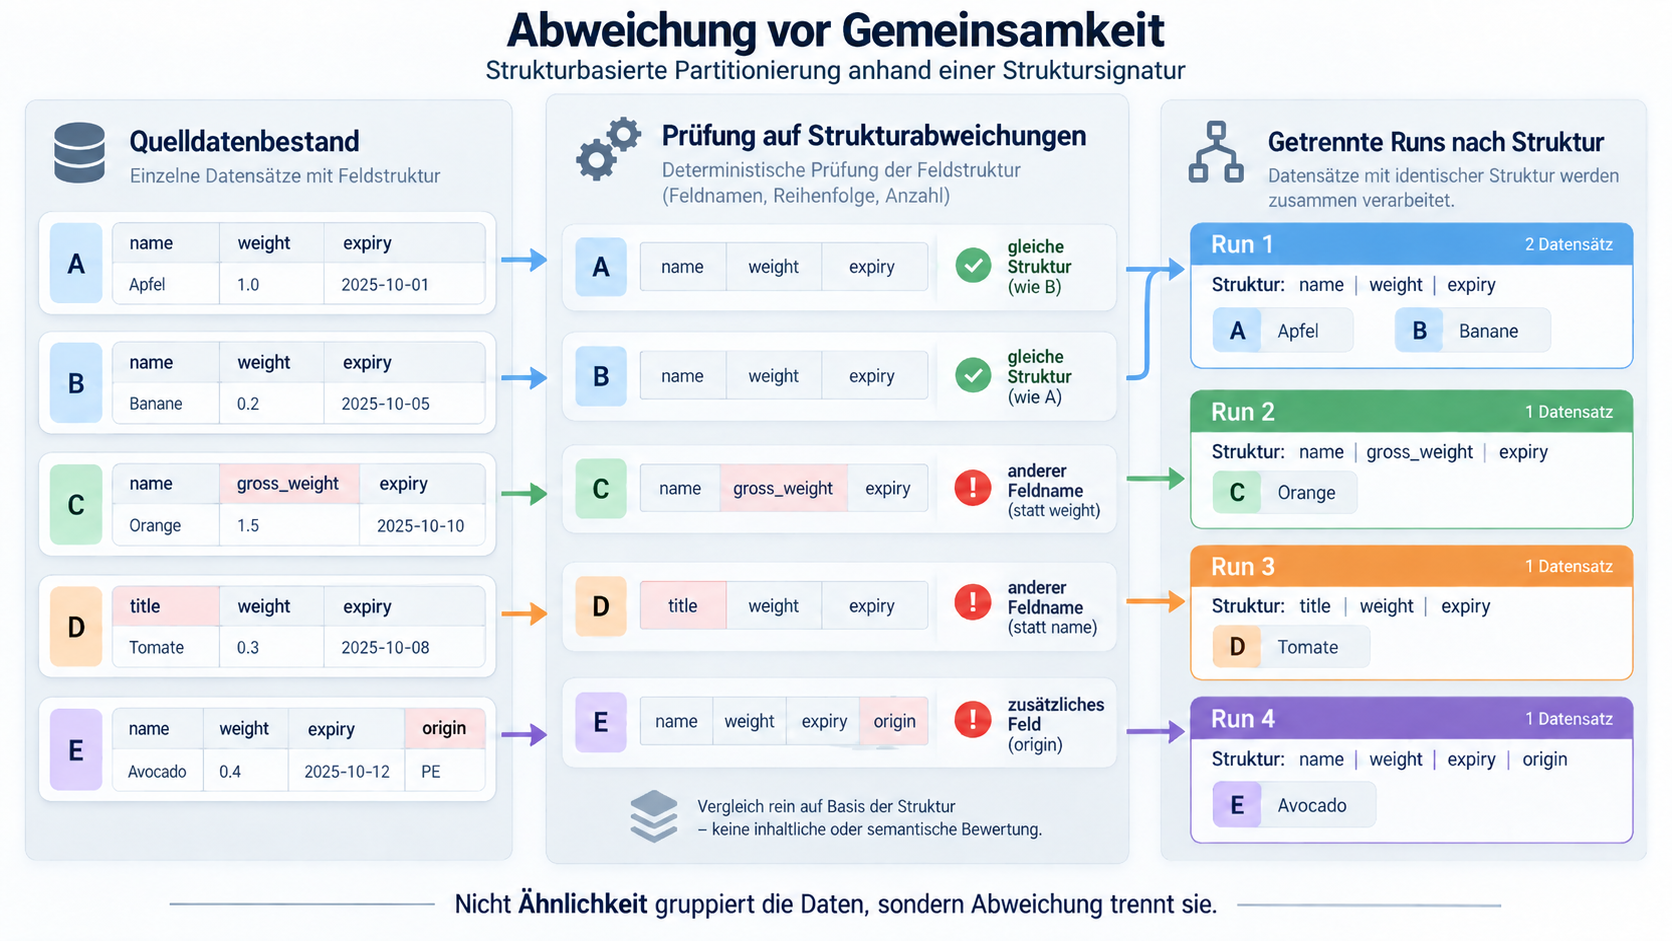
Ein wesentlicher Grundsatz der Migration lautet: Nicht nach Gemeinsamkeiten suchen, sondern nach Strukturabweichungen.
Viele Migrationsansätze beginnen mit der Frage, welche Datensätze sich ähneln. Feldnamen werden verglichen, Muster erkannt und vermeintlich gleichartige Strukturen zusammengeführt. Dieser Ansatz kann funktionieren, setzt jedoch voraus, dass Ähnlichkeit tatsächlich auf dieselbe technische oder fachliche Struktur hinweist.
Für eine deterministische Migration ist der umgekehrte Weg robuster.
Ausgangspunkt ist zunächst die Annahme, dass Datensätze nur dann gemeinsam verarbeitet werden, wenn ihre relevante Struktur nach den festgelegten Regeln übereinstimmt. Die Engine sucht daher nicht aktiv nach Gründen, zwei Strukturen zusammenzufassen. Sie sucht nach Merkmalen, die sie voneinander unterscheiden.
Eine Abweichung kann beispielsweise bestehen in:
- einem zusätzlichen oder fehlenden Feld
- einem abweichenden Feldnamen
- einem anderen Datentyp
- einer anderen Verschachtelung
- einer abweichenden technischen Herkunft
- einer relevanten Längen- oder Formatdefinition
- einer strukturell bedeutsamen Reihenfolge
Wird eine solche Abweichung festgestellt, entstehen zunächst getrennte Strukturgruppen.
Das bedeutet nicht, dass diese Gruppen fachlich verschieden sein müssen. Zwei unterschiedliche Quellstrukturen können später durchaus auf dieselben Zielfelder abgebildet werden. Diese Zusammenführung geschieht jedoch bewusst im Mapping und nicht bereits während der Strukturerkennung.
Damit werden zwei Aufgaben sauber voneinander getrennt:
Die Strukturerkennung beantwortet die Frage, ob Quelldaten technisch gleich aufgebaut sind.
Das Mapping beantwortet die Frage, ob unterschiedliche Quellstrukturen auf dieselben Zielstrukturen abgebildet werden sollen.
Diese Trennung verhindert, dass eine vermutete Gemeinsamkeit bereits während der Analyse zu einer dauerhaften Zusammenführung führt.
Der Ansatz ist bewusst konservativ: Eine zusätzliche Strukturgruppe erzeugt zunächst nur mehr Arbeit. Eine fälschlich zusammengeführte Struktur kann dagegen dazu führen, dass Daten unter falschen Annahmen verarbeitet werden.
Deshalb gilt:
Abweichungen werden früh sichtbar gemacht. Gemeinsamkeiten werden erst dann genutzt, wenn sie ausdrücklich bestätigt oder technisch eindeutig definiert sind.